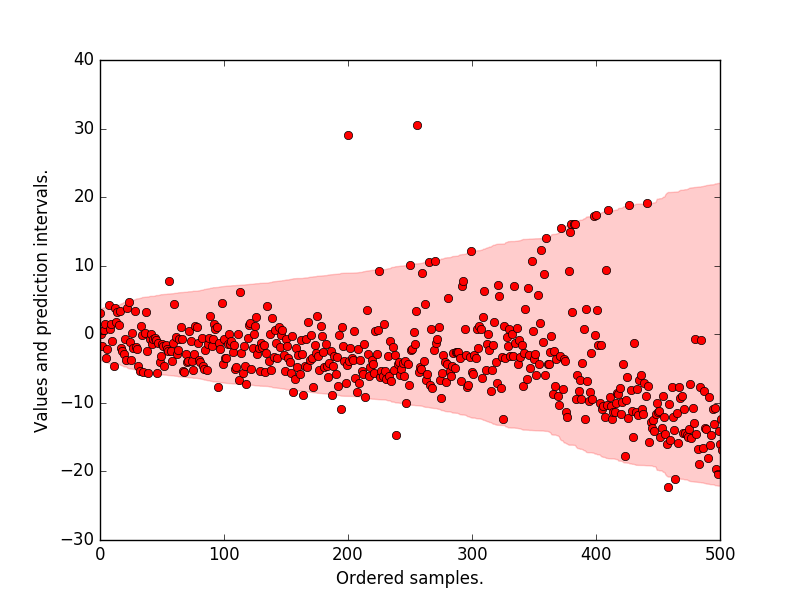
QRT & QRF
- Published time
前言#
大部分的迴歸模型回答的是同一個問題:「給定這些特徵,y 的平均值是多少?」但很多時候,我們真正想知道的不是平均值,而是整個分布。
外送要等多久、明天的報酬率會落在哪個區間、這批貨的交期最壞會拖到什麼時候——這些問題的答案都不是一個數字,而是一個範圍。
這篇會從 Quantile Regression 講起,接著介紹 Regression Tree,最後把兩者組合起來,說明 Quantile Regression Tree(QRT)與 Quantile Regression Forest(QRF)分別在做什麼。
Quantile Regression#
先舉個例子。
在等待外送的時候,App 上顯示的預估時間通常是一個範圍,而不是一個確切的時間點。這裡用的就是 Quantile Regression:它同時預測了 75 分位數和 25 分位數,所以有 50% 的機率你會在這個區間內拿到餐點。
換個方式理解:如果我們固定 input 的範圍(這裡使用 7~8 公里),把對應的所有 y 拿出來畫成盒狀圖,看到的會是這樣:


可以看到 75% 的樣本低於 26 分鐘,25% 的樣本低於 18 分鐘。Quantile Regression 做的就是直接對這些分位數建模。
損失函數的差異#
兩種迴歸的差別,完全體現在損失函數上。
OLS:


這樣得到的是在給定 data 下的條件平均數。因為誤差被平方,離群值的影響會被放大。
Quantile:


這樣得到的是在給定 data 下的條件分位數。這個損失函數(又叫 pinball loss)的精神是不對稱懲罰:預測 90 分位數時,低估的懲罰遠大於高估,模型自然會把預測往上推,直到剛好有 90% 的樣本落在下方為止。
如果從分布的角度來想,每一組 data 產生的 y 本身都是一個分布,我們只是去取這個分布的某個百分位數。如果用 OLS 來做,我們還需要先假設誤差的分布(通常假設常態),但誤差項不一定服從穩定的分布,我們也無從得知;而 Quantile Regression 中每個分位數都有自己的一組參數,它們對特徵的反應也可以完全不同。
其實最重要的就是這個損失函數。這邊不打算證明這個數學式,但要記得的是:無論什麼模型,只要套用這個損失函數,就會得到分量回歸的結果。代價是它一次只能預測一個分位數,想要幾個分位數,就要訓練幾次。
它的強項#
Quantile Regression 的強項在於,y 可能在不同的級距下有不同的分布行為。
一樣舉外送的例子:在較近的距離,等待時間受紅綠燈的影響比較小;但在較長的距離,紅綠燈的影響就會被放大。再舉個例子,以財報預測報酬而言,可能在報酬率較高的區間,模型對某些特定關鍵字更敏感,而在報酬率較低的區間,同樣的關鍵字幾乎沒有影響。OLS 只會給你一組係數,看不到這種變化。
另外,如果拿 OLS 跟預測 50 分位數的 Quantile Regression 相比,前者受極端值的影響較大,後者則幾乎不受影響——因為它預測的是中位數,而且對誤差不需要任何分布假設。
Regression Tree#
決策樹的目的是:在給定新的 data input 時,能根據特徵值的切分,一路走到對應的輸出值。
所以在訓練時,它做的事情就是把特徵空間切分成很多個區塊。決策樹模型的圖示如下:


每次分割時會尋找一個特徵和它的最佳切分點,把資料分成兩邊,一直分割直到達到設定的深度。底下說明它的演算法流程:
-
選擇最優的切分變數,白話說就是找出所有 feature 和 threshold 的組合中最好的一組:
其中 c 是各自群組的平均值。
-
根據所選的切分變數決定輸出值:
這個輸出值指的就是:當新的 input 在這個節點停下時,預測值為何。
-
重複步驟 1、2,直到滿足停止條件為止。
-
最後完成空間的劃分,生成決策樹。


上面這個是針對一般的 regression,它用節點內樣本的平均值當作預測值。所以可以想像分完之後的結果就是所有資料被分類,每一個分類都有一個預測值,而這個預測值是讓該分類內所有樣本的平方誤差最小的那個數——也就是平均數。
Quantile Regression Tree#
如果結合以上兩者,其實就只是把 Regression Tree 裡的損失函數換掉:


其中:


所以可以想像,最後每一個分類的預測值會變成該分類的某個百分位數,也就是讓該分類內所有樣本的分位數損失最小的那個值。可能不是那麼直覺哈哈,但邏輯是一致的:平方誤差的最佳解是平均數,分位數損失的最佳解就是分位數。
Quantile Regression Forest#
QRF 與隨機森林(Random Forest)的訓練方式相同:它會生成許多決策樹,每棵樹都使用隨機抽樣的資料與特徵來訓練。
但關鍵的不同在於——Random Forest 在每個葉節點只保留「平均值」,而 Quantile Regression Forest 會保留該節點中所有樣本的實際輸出值 Y_i。
這裡有一個重點值得注意:QRF 依然是用 MSE 作為分裂準則,也就是說,樹的結構和一般的隨機森林完全一樣,差別只發生在預測階段。
所以當我們要對新的樣本 x 做預測時,QRF 會把 x 丟進所有的樹中,每棵樹都會找到 x 所落入的葉節點,並記錄該節點中所有訓練樣本的索引。
這樣每個訓練樣本 i 就會得到一個權重 w_i(x),代表「在所有樹中,樣本 i 與 x 落在相同葉節點的頻率」。這些權重構成了 x 在訓練樣本中的鄰近關係——換句話說,森林被當成一個學習出來的相似度度量,跟 x 越像的樣本權重越高。
接著,QRF 就用這些加權樣本來估計條件分布,也就是建構出一個經驗累積分布函數(Empirical CDF)。
有了這個分布函數,就可以預測任意想要的分位數。這也是 QRF 相較於 QRT 最大的優勢:只要訓練一次,就能得到所有分位數,不必像單純的分位數回歸那樣,每個分位數都重新訓練一遍。
結語#
把這幾個模型放在一起看,它們其實是同一個想法的不同層次:
- Quantile Regression:換掉損失函數,得到條件分位數而非條件平均數。
- Quantile Regression Tree:把同樣的損失函數套進樹模型。
- Quantile Regression Forest:不換損失函數,改為在葉節點保留完整樣本,直接估出整個條件分布。
在意風險、在意最壞情況、或是資料本身異質性很高的場景,這一類方法會比只給一個平均值的模型有用得多。
這篇文章的內容就到這邊。