Reinforcement Learning(I)
- 發佈時間
前言#
這個系列主要是紀錄我個人研讀強化學習的一些心得。跟一般逐章介紹的方式不太一樣,我希望用一個「全域總整理」的角度,把整個強化學習的理論演進串起來:每一個階段是為了解決前一個階段的什麼問題而出現的,又是怎麼從前一個階段自然延伸出來的。
內容主要整理自趙世鈺老師的《Mathematical Foundations of Reinforcement Learning》一書與對應的課程,文中的 pseudocode 也都取自該教材。
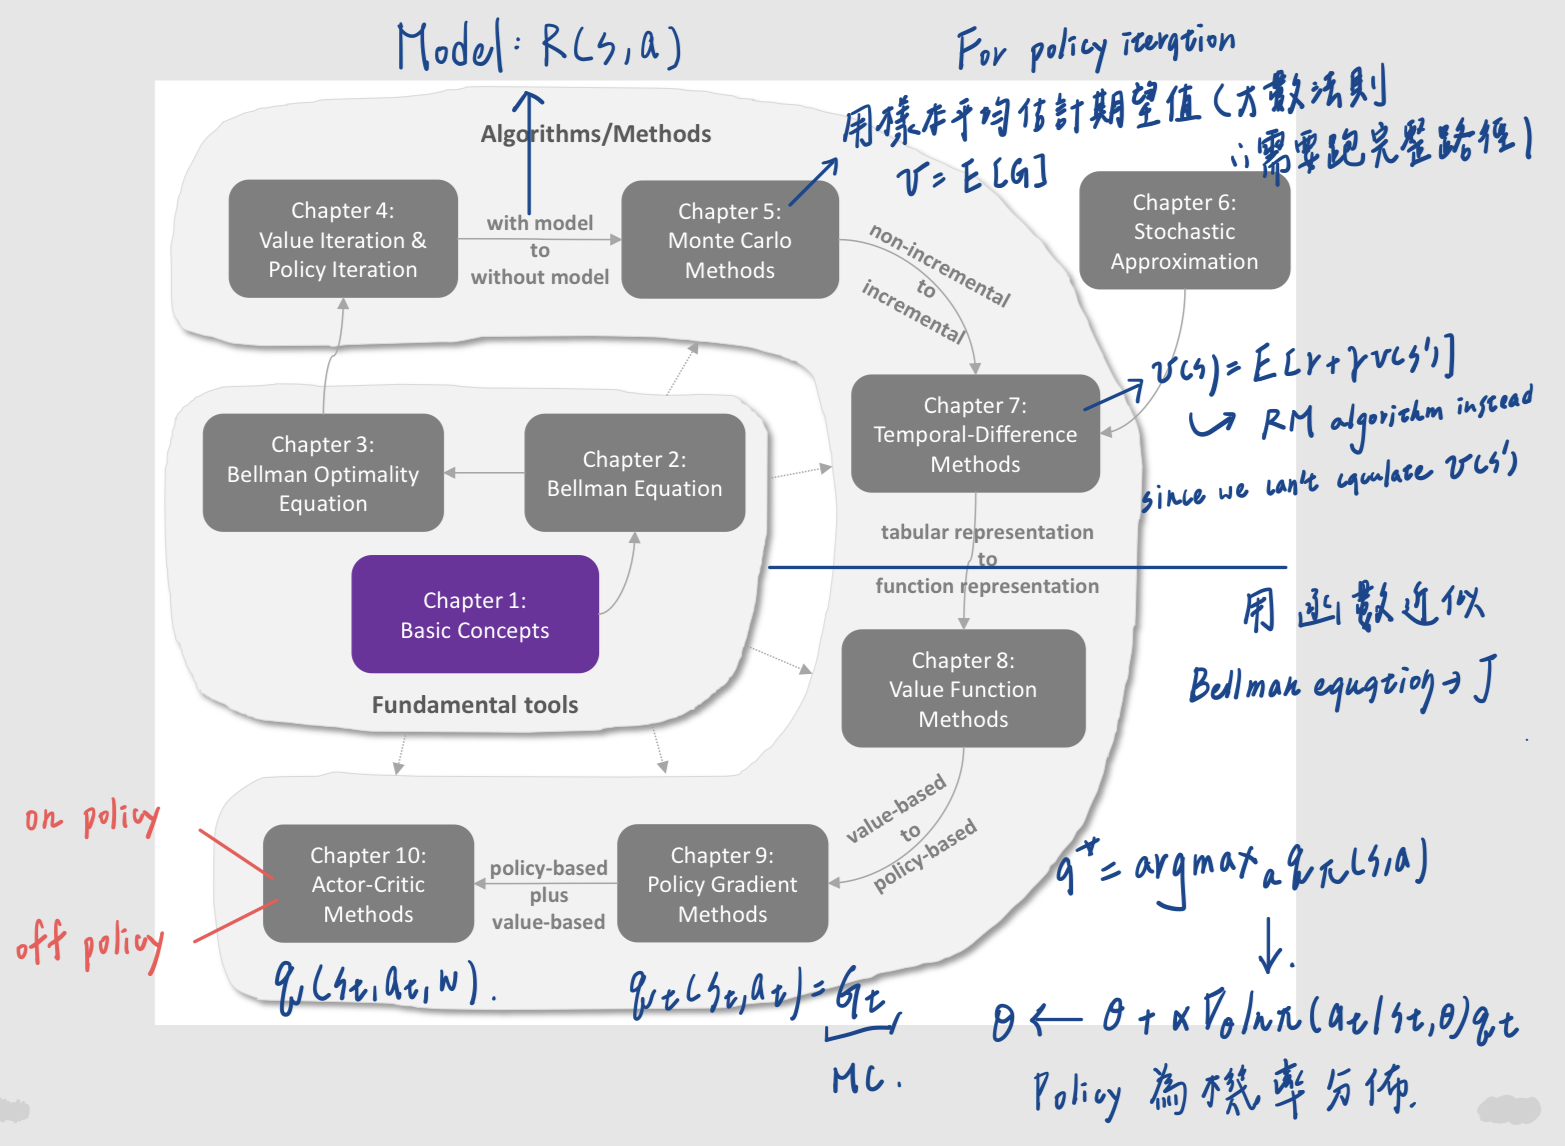
上面這張圖是整個系列的地圖。可以看到從每個階段到下一個階段都有明確的定義:
- Chapter 1-3 是基礎工具:基本概念、Bellman equation、Bellman optimality equation
- Chapter 4 是在模型已知(with model)的情況下求最佳策略:Value iteration 與 Policy iteration
- Chapter 5-7 是從 with model 走到 without model(model-free):Monte Carlo、Stochastic approximation、Temporal-Difference
- Chapter 8 是從表格表示走到函數表示(function approximation)
- Chapter 9-10 是從 value-based 走到 policy-based:Policy gradient 與 Actor-Critic
這個系列會拆成三篇,分別對應上面的三個區塊:
- 本篇:基本概念、Bellman equation、Bellman optimality equation、Value iteration 與 Policy iteration
- Reinforcement Learning(II):Monte Carlo、Robbins-Monro 與 SGD、TD learning、Sarsa 與 Q-learning
- Reinforcement Learning(III):函數近似、DQN、Policy gradient、REINFORCE 與 Actor-Critic
底下就先從基礎工具開始,把這個轉變的過程說明得更順暢。
基本名詞與符號#
首先,一定要先定義一些在強化學習領域會大量用到的名詞。這裡用書中的 grid world 當背景:agent 在一個格子世界裡移動,有些格子是禁區(forbidden),有一個格子是目標(target),agent 的任務是找到一條走到 target 的好路徑。
State(狀態):agent 相對於環境的狀態,記作 。在 grid world 裡,state 就是 agent 所在的位置。
State space(狀態空間):所有 state 的集合,記作 。
Action(動作):在某個 state 下可以採取的動作,記作 。在 grid world 裡有五個動作:上、右、下、左、原地不動,分別記作 。
Action space of a state(某個狀態的動作空間):在 state 下所有可採取的動作的集合,記作 。之所以要寫成 的函數,是因為不同 state 可採取的動作可能不同。
State transition(狀態轉移):在 state 採取 action 後,agent 移動到 state 的過程。它用條件機率來描述:
例如在 往右走一定會到 ,就是 ,其他 的機率都是 。當然 state transition 也可以是隨機的,這個表示法都能涵蓋。
Policy(策略):告訴 agent 在每個 state 該採取什麼 action,同樣用條件機率描述:
如果 只在某一個 action 上是 、其他都是 ,就叫 deterministic policy;否則就是 stochastic policy。
Reward(獎勵):採取一個 action 之後環境回饋的一個實數,記作 。它同樣可以是隨機的,用 描述。Reward 可以想成是人跟 agent 溝通的方式:撞到邊界或進到 forbidden 給負的 reward,到達 target 給正的 reward,其他情況給 。要注意 reward 取決於當下的 state 跟 action,而不是取決於下一個 state。
Trajectory 與 return:trajectory 是一條 state-action-reward 的鏈:
沿著這條 trajectory 收到的所有 reward 加總就叫 return,。Return 可以用來評估一個 policy 的好壞:從同一個 state 出發,return 越大的 policy 越好。
Discounted return(折扣回報):當 trajectory 無限長時,return 可能會發散,所以引入一個 discount rate :
除了讓 return 收斂之外,也控制了 agent 的眼光: 越接近 ,越看重近期的 reward(短視);越接近 ,越看重長遠的 reward。
Episode:agent 依照 policy 走到 terminal state 就停止的一段 trajectory。有終止狀態的任務叫 episodic task,沒有的則叫 continuing task。在數學上可以把 terminal state 視為一個 absorbing state(進去之後就不會再出來,之後的 reward 都是 ),這樣兩種任務就能用同一套框架處理。
Markov decision process(MDP):把上面所有東西整合起來的數學框架,它包含:
- 集合:state space 、action space 、reward set
- 模型:state transition probability 與 reward probability
- Policy:
- Markov property:下一個 state 與 reward 只跟現在的 state 與 action 有關,跟更早的歷史無關,也就是
Markov property 是後面所有推導能夠成立的關鍵:正是因為未來只取決於現在,我們才能把一個 state 的價值寫成「當下的 reward 加上下一個 state 的價值」這樣的遞迴形式,也就是接下來的 Bellman equation。
State value 與 Bellman equation#
有了上面這些名詞之後,接著來看 Bellman equation 和 Bellman optimality equation。
State value#
首先要定義什麼叫 state value。從時間 開始,記 state 為 、採取的 action 為 、收到的 reward 為 ,那 discounted return 就是一個隨機變數:
State value 就是在給定 policy 之下,從 state 出發所能得到的 return 的期望值:
之所以要取期望值,是因為 policy、state transition、reward 都可能是隨機的,從同一個 state 出發可以走出很多條不同的 trajectory,每一條的 return 都不一樣。State value 越大,代表這個 policy 從這個 state 出發平均能拿到越多 reward,所以 state value 可以用來評估 policy 的好壞。
Bellman equation#
Bellman equation 描述的是不同 state 的 state value 之間的關係。它的公式是:
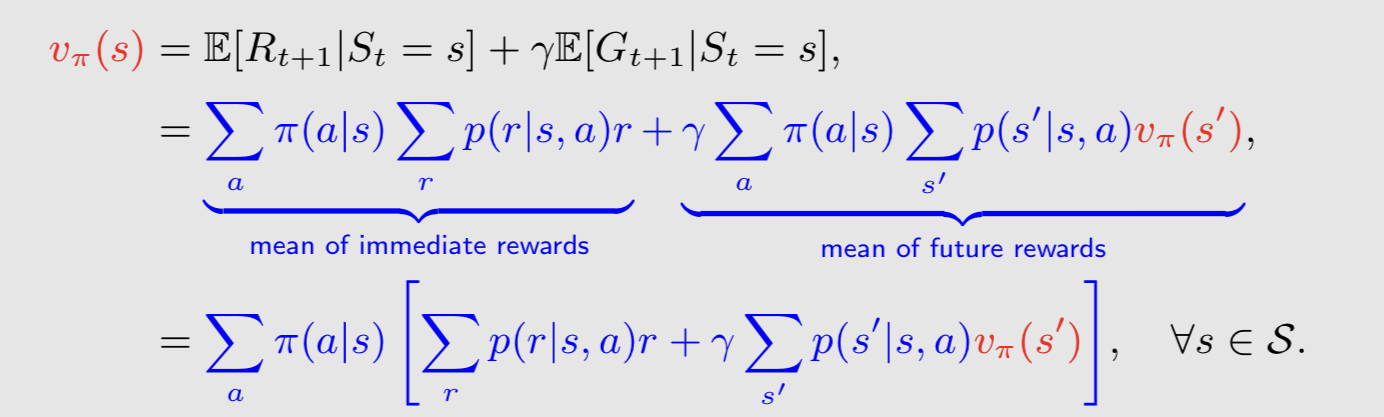
推導的關鍵是把 return 拆成兩段,,所以 state value 也就由 immediate reward 和 future reward 兩個期望值組成:
- 第一項 是 immediate reward 的期望值
- 第二項 是 future reward 的期望值,也就是下一個 state 的 state value 打折之後再取平均
這裡有幾點值得注意:
- Bellman equation 不是一條式子,而是對每個 都有一條,所以它其實是一組聯立方程式。
- 式子裡的 與 都是未知數,要把整組一起解才能求出所有的 state value。
- 它依賴 policy 以及模型 、。所以 Bellman equation 做的事是「給定一個 policy,求出它的 state value」,這個過程叫做 policy evaluation。
把所有 state 的式子疊起來,Bellman equation 可以寫成矩陣形式:
其中 是所有 state value 排成的向量, 是每個 state 的 immediate reward 期望值排成的向量, 是在 policy 之下的 state transition matrix。要解它有兩種方式:
- Closed-form solution:,但矩陣求逆在 state 很多的時候計算量太大,實務上很少用
- Iterative solution:,從任意的 開始反覆代入,可以證明
後面 policy iteration 裡的 policy evaluation 用的就是第二種方式。
Action value#
除了 state value,還有一個很常用的 action value,定義成從 state 採取 action 之後所能得到的 return 期望值:
兩者的關係是:
也就是說 state value 是 action value 依照 policy 取的加權平均;反過來,action value 就是 Bellman equation 方括號裡的那一項。Action value 之所以重要,是因為當我們想改進 policy 時,需要知道的正是「在這個 state 下哪個 action 比較好」,而這正是 action value 在比較的東西。
Bellman optimality equation#
另外一個叫做 Bellman optimality equation:
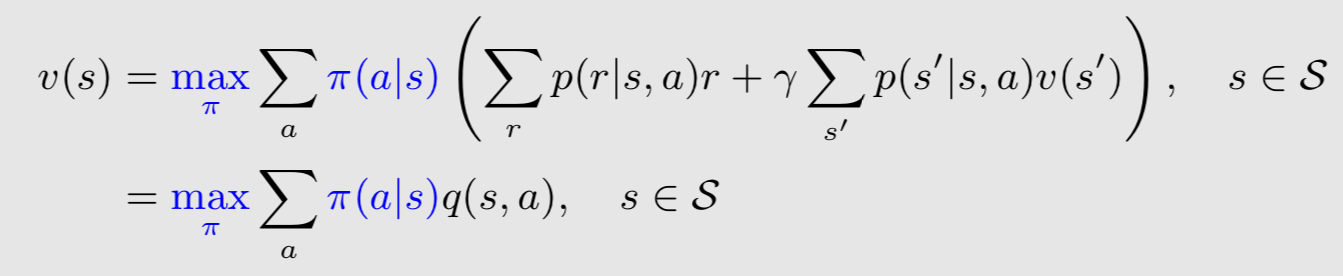
這裡可以看到它加入了一個 ,所以它得到的是 max value。
Optimal policy#
先定義什麼叫最佳策略。如果一個 policy 對所有的 state 都滿足 ,其中 是任意其他的 policy,那 就是 optimal policy,它的 state value 就叫 optimal state value。這個定義馬上帶出幾個問題:optimal policy 存在嗎?唯一嗎?長什麼樣子?要怎麼求?Bellman optimality equation 就是回答這些問題的工具。
怎麼解 Bellman optimality equation#
跟 Bellman equation 比起來,這條式子多了一個 ,看起來右邊同時有 跟 兩個未知數。解法是分成兩步:
第一步,先固定 ,對右邊求 。因為 是 的加權平均,而加權平均永遠不會超過最大值,所以最佳的做法就是把全部的權重放在 最大的那個 action 上:
第二步,把 消掉之後,式子就變成 ,也就是 的形式。可以證明 是一個 contraction mapping,所以根據 contraction mapping theorem,這條式子有唯一解 ,而且用 反覆迭代就會收斂到 。
這個 就是 optimal state value,對應的 greedy policy 就是 optimal policy。所以結論是:optimal policy 一定存在;optimal state value 唯一,但 optimal policy 不一定唯一(多個 action 的 action value 相同時可以任選);而且 optimal policy 一定可以取成 deterministic 且 greedy 的形式,也就是在每個 state 選 action value 最大的那個 action。
兩者的差異#
那上面兩個的差異,就是在 Bellman equation 其實需要先給定一個 policy,然後才會給你一個 value function;而 Bellman optimality equation 則是會求出 max value,並進而得到 policy。
換句話說,前者是「評估」,後者是「求最佳」。這樣講可能有點抽象,可以從兩者所延伸出來的演算法來實際說明看看:
- Bellman equation 所延伸出的演算法是 Policy iteration
- Bellman optimality equation 所延伸出的演算法則是 Value iteration
底下可以透過兩個例子清楚看出它們的差異。
Value iteration#
演算法#
Value iteration 其實就是上一節解 Bellman optimality equation 的迭代法 ,只是把每一步拆開來看:
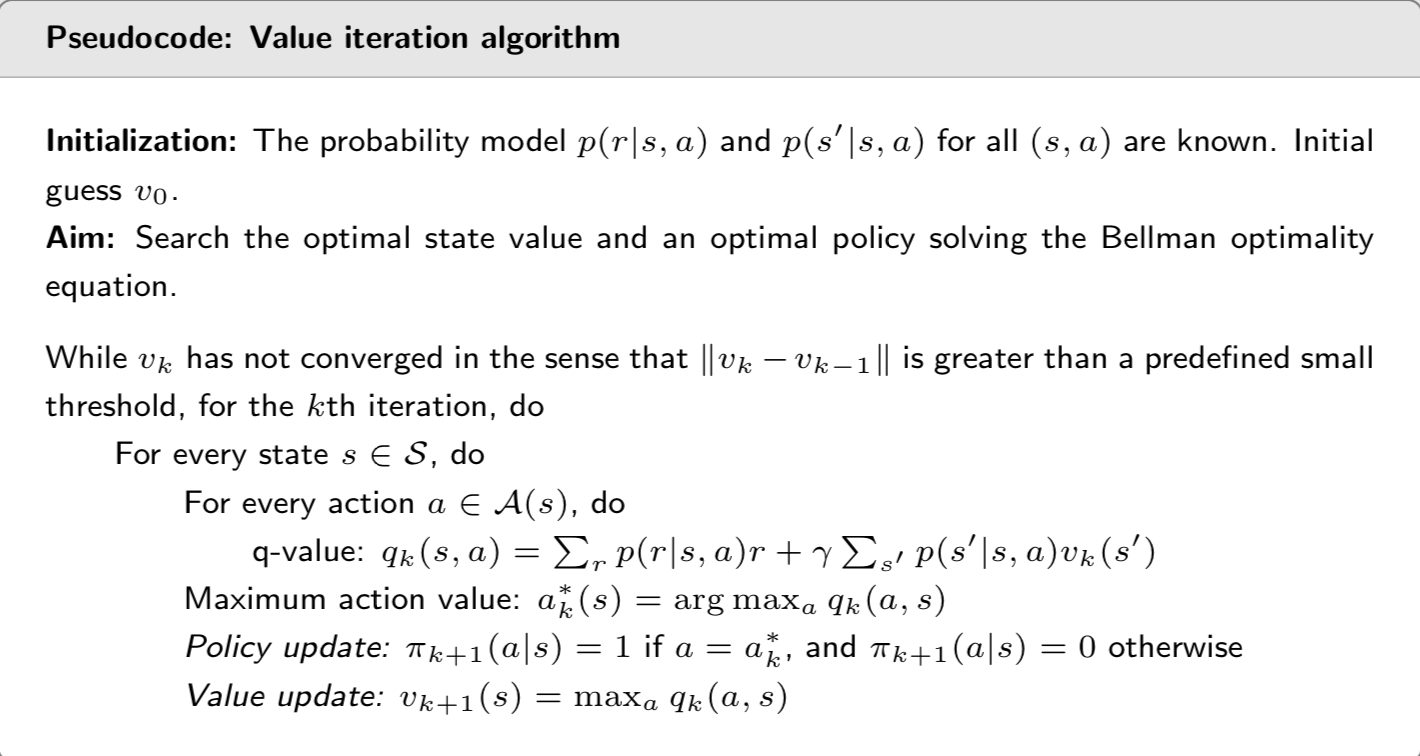
每一輪迭代分成兩步:
- Policy update:用目前的 算出每個 state-action pair 的 ,然後在每個 state 選出 最大的 action 當作新的 policy (greedy)
- Value update:,也就是把 的最大值當作新的 state value
要注意的是,迭代過程中的 並不是任何一個 policy 的 state value(它不滿足 Bellman equation),它只是一個中間值。要等到收斂之後, 才會等於 。
例子#
用一個 的 grid world 來實際跑一次:
| (forbidden) | |
| (target) |
五個 action 分別是 上、 右、 下、 左、 原地不動。Reward 設定為進入 forbidden 或撞到邊界 、進入或停留在 target 、其他 ,discount rate 。
因為模型已知,可以先把每一格的 用 的式子寫下來(q-table):
每一格的意思都是「immediate reward 加上 乘以下一個 state 的 value」。例如 往上會撞到邊界、留在原地,所以是 ; 往下會進到 target,所以是 。
k = 0:令 ,代入 q-table:
Policy update,每個 state 取最大值對應的 action:
( 的 與 同為最大值 ,兩個都可以,這裡選 。)
Value update,每個 state 取最大的 q-value:
k = 1:把 代回 q-table():
Policy update:
Value update:
可以看到 的策略從「原地不動」變成「往下走」。這時候的 policy 其實已經是最佳的了( 往下到 、 往右到 、 往下到 、 停留),但 value 還沒收斂。接下來繼續迭代,policy 不會再變,只有 value 會持續往 逼近,直到 小於門檻為止。最後收斂到的 optimal state value 是 、(例如 解出 )。
Policy iteration#
演算法#
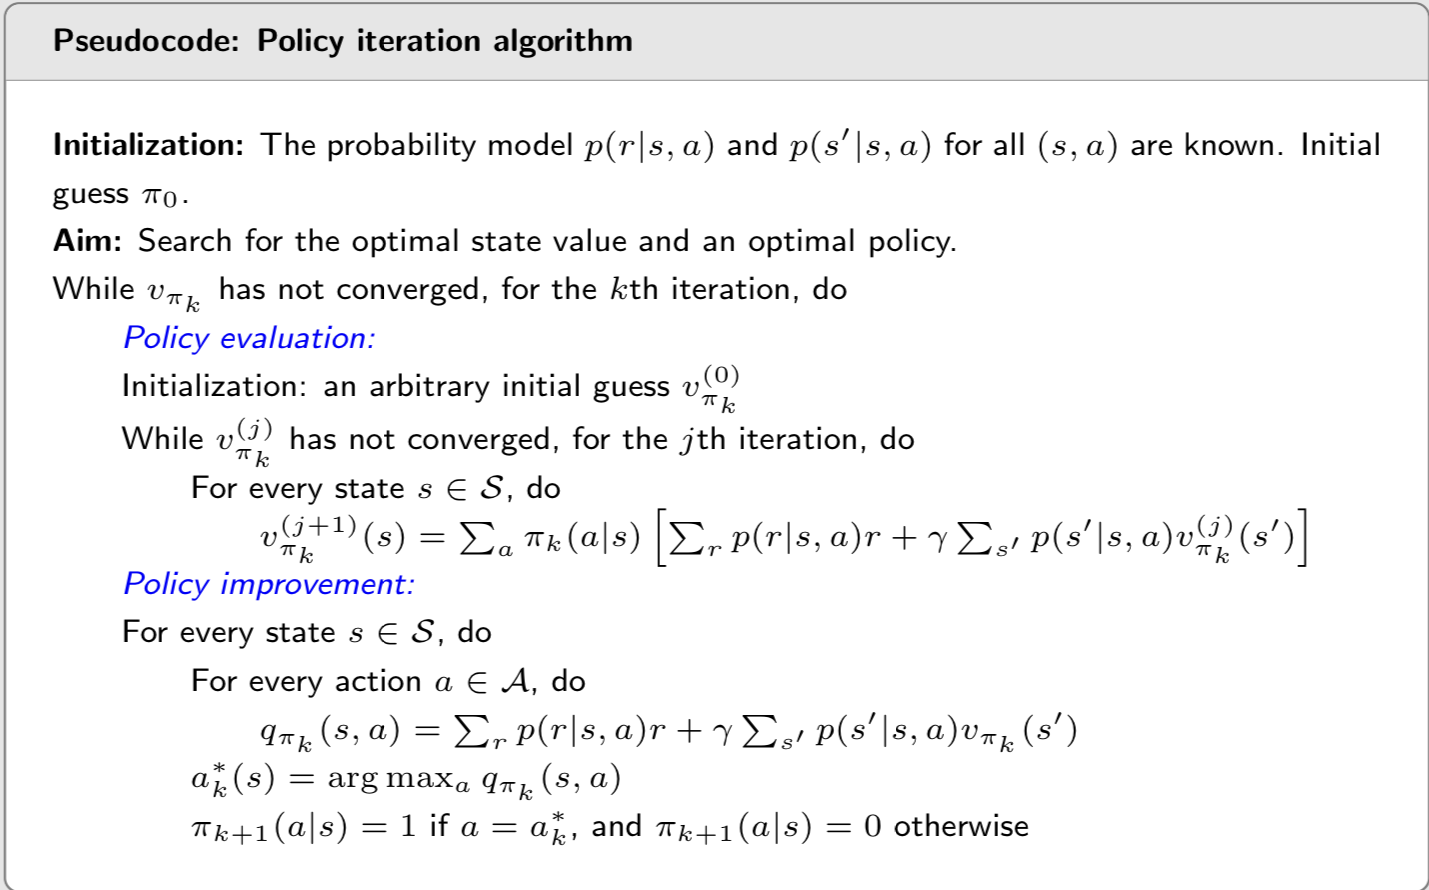
Policy iteration 則是從一個初始的 policy 出發,每一輪做兩件事:
- Policy evaluation:解 Bellman equation 求出目前 policy 的 state value。這本身就是一個迭代的過程(pseudocode 裡的內層 迴圈),state 少的時候也可以直接用 closed-form 解。
- Policy improvement:用 算出 ,然後在每個 state 取 greedy action 得到 。
可以證明每一輪 improvement 之後 ,而且 最終會收斂到 optimal policy。
跟 value iteration 最大的差異在於:policy iteration 每一輪的 是一個真正的 policy 的 state value(滿足 Bellman equation),所以它是「評估、改進、評估、改進」的循環;而 value iteration 的 只是中間值,它等於是把 policy evaluation 只做一步就直接 improvement。這也正好對應到它們各自的根源:Bellman equation 與 Bellman optimality equation。介於兩者之間的做法(policy evaluation 只迭代固定的幾步就停)叫做 truncated policy iteration,實務上常用的其實是這種。
例子#
用一個更簡單的例子:只有兩個 state, 是 target,action 有 (左)、(不動)、(右)。Reward 設定同樣是撞到邊界 、進入或停留在 target 、其他 ,。
| (target) |
初始策略 是兩個 state 都往左走:、。直覺上這是一個很差的策略。
k = 0,Policy evaluation:依照 寫出 Bellman equation:
( 往左撞牆留在原地拿 ; 往左到 拿 。)這組方程式可以直接解,也可以用迭代解,結果是:
k = 0,Policy improvement:用剛才的 state value 算出 action value:
每個 state 取最大值:
也就是 往右走到 target、 留在 target。這已經是 optimal policy 了,只用了一輪就從最差的策略跳到最好的策略。這裡值得注意的是,雖然 全部都是負的(因為 很差),但 policy improvement 比較的是同一個 state 之下不同 action 的相對大小,所以還是能正確選出好的 action。
如果再跑一輪,policy evaluation 會得到 、,解出 ;policy improvement 之後 policy 不再改變,演算法就收斂了。
小結#
到這裡為止,我們還是在 with model 的範疇。所謂的 with model,就是需要知道 state transition probability 跟 reward probability ,這類方法統稱為 dynamic programming。但在實際情況中,我們大多數時候不會知道這兩個東西,所以會需要 model-free 的方法。
下一篇 Reinforcement Learning(II) 就從 Monte Carlo 開始,看看怎麼在沒有模型的情況下用樣本取代期望值,再經過 Robbins-Monro 與 SGD,一路走到 TD learning、Sarsa 與 Q-learning。