Reinforcement Learning(III)
- 發佈時間
前言#
這是強化學習系列的第三篇,也是最後一篇。第一篇建立了 Bellman equation 與 Bellman optimality equation 這兩個基礎工具,並在模型已知的情況下用 value iteration 與 policy iteration 求出最佳策略;第二篇則用 Monte Carlo 與 TD learning 擺脫了模型,得到 Sarsa 與 Q-learning。
但到目前為止,所有的方法都還是 tabular 的:把每個 存在一張表裡。這一篇要做兩件事:先從表格走到函數(function approximation),再從 value-based 走到 policy-based。
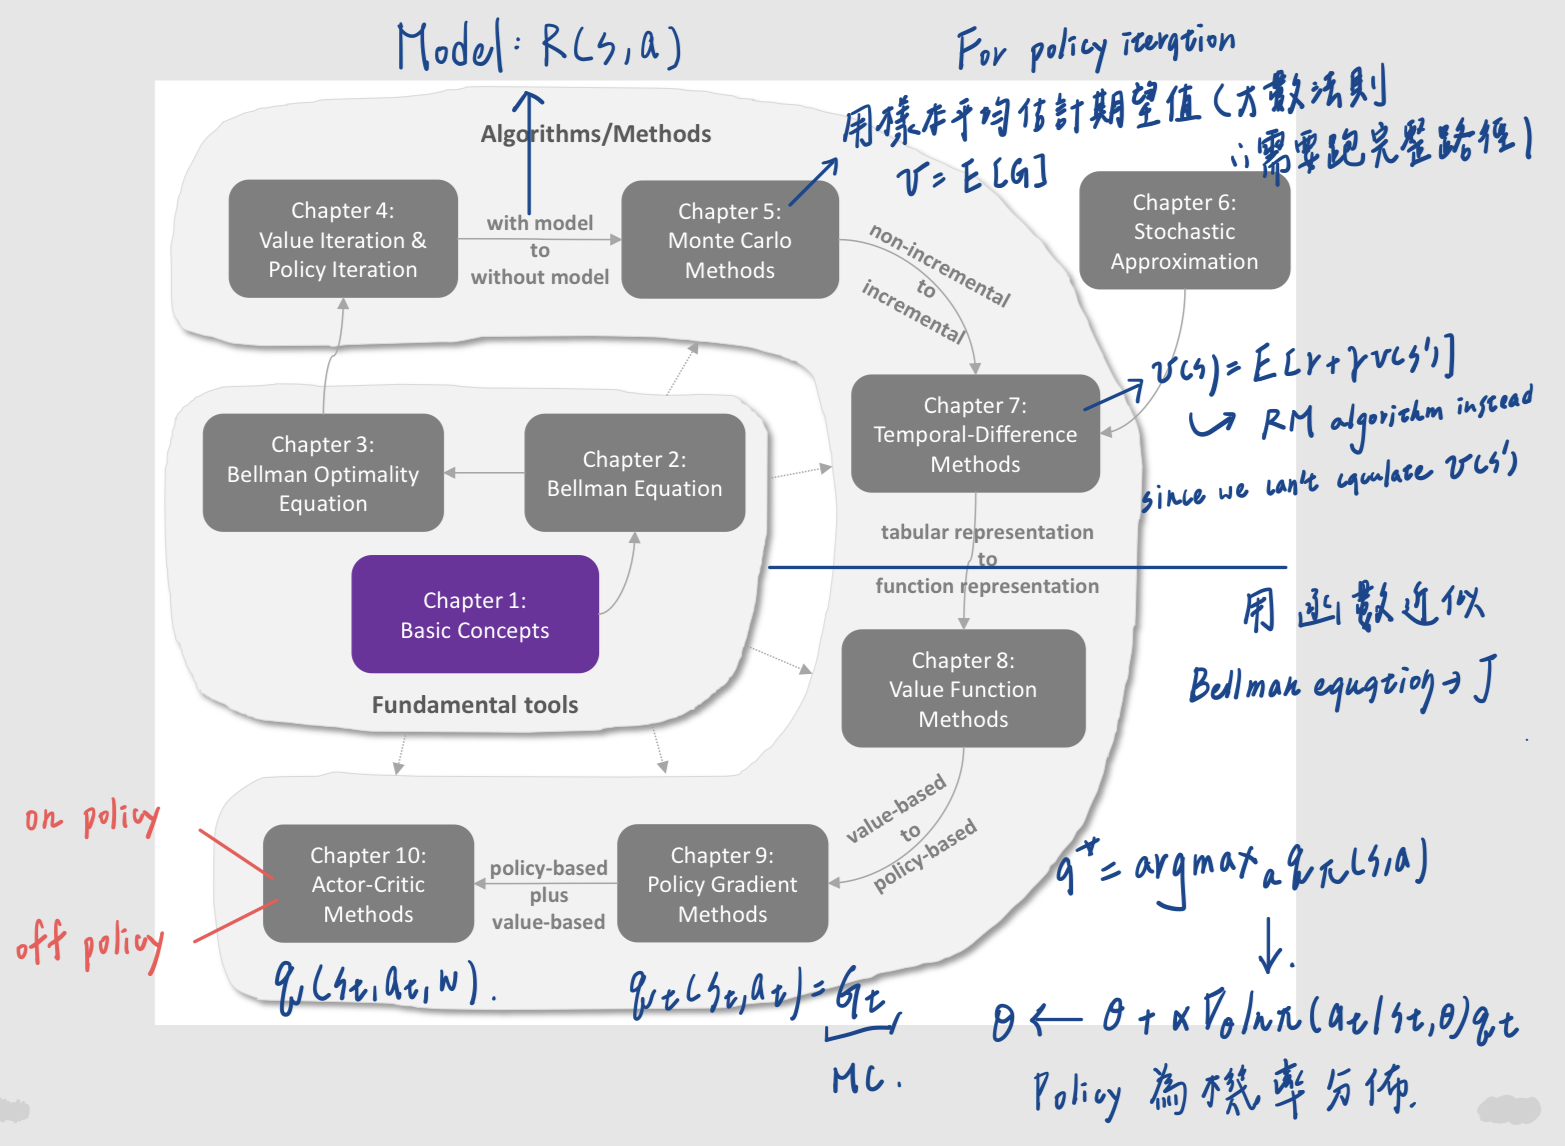
對應到 overview 圖,這篇涵蓋的是 Chapter 8-10:
- Value function approximation:把 Sarsa 與 Q-learning 從表格改寫成函數,並引入深度神經網路得到 DQN
- Policy gradient:直接把 policy 參數化,用 gradient ascent 最佳化,得到 REINFORCE
- Actor-Critic:把 policy gradient 跟 TD 的 value 估計結合起來
從表格到函數:Value function approximation#
為什麼需要函數近似#
Tabular 的方法對 analyze 來說非常方便,但缺點是 difficult to handle large or continuous state or action spaces,不管從 storage 還是 generalization ability 來看都是:
- Storage:表格的大小是 ,state 一多就存不下;state 或 action 是連續的時候根本無法列舉
- Generalization:表格裡每一格是獨立更新的,更新一個 對其他格子完全沒有影響,所以沒拜訪過的 state 就沒有任何資訊
所以我們要做的就是 from table to function:用一個帶參數 的函數 來近似 。最簡單的是線性函數 ,其中 是特徵向量;更一般的則是用神經網路。這樣一來只需要儲存 ,而且更新 會同時改變所有 state 的值,沒看過的 state 也能靠相似的特徵得到合理的估計。
怎麼學參數 #
以估計 state value 為例,最自然的目標函數是估計值與真實值之間的均方誤差:
用上一篇的 SGD 來最小化它:
但 正是我們不知道的東西。解法跟上一篇一模一樣:用 MC 的 return 代替就是 MC with function approximation;用 TD target 代替就是 TD with function approximation。這就是 overview 圖上寫的「用函數近似 Bellman equation → J」:把解 Bellman equation 的問題改寫成最小化一個目標函數 。要注意 TD target 裡也含有 ,但更新時把它當成常數、不對它微分,所以嚴格說這不是真正的 gradient,而是 semi-gradient。
把 state value 換成 action value,就得到 Sarsa 與 Q-learning 的函數近似版本。
Sarsa with function approximation#
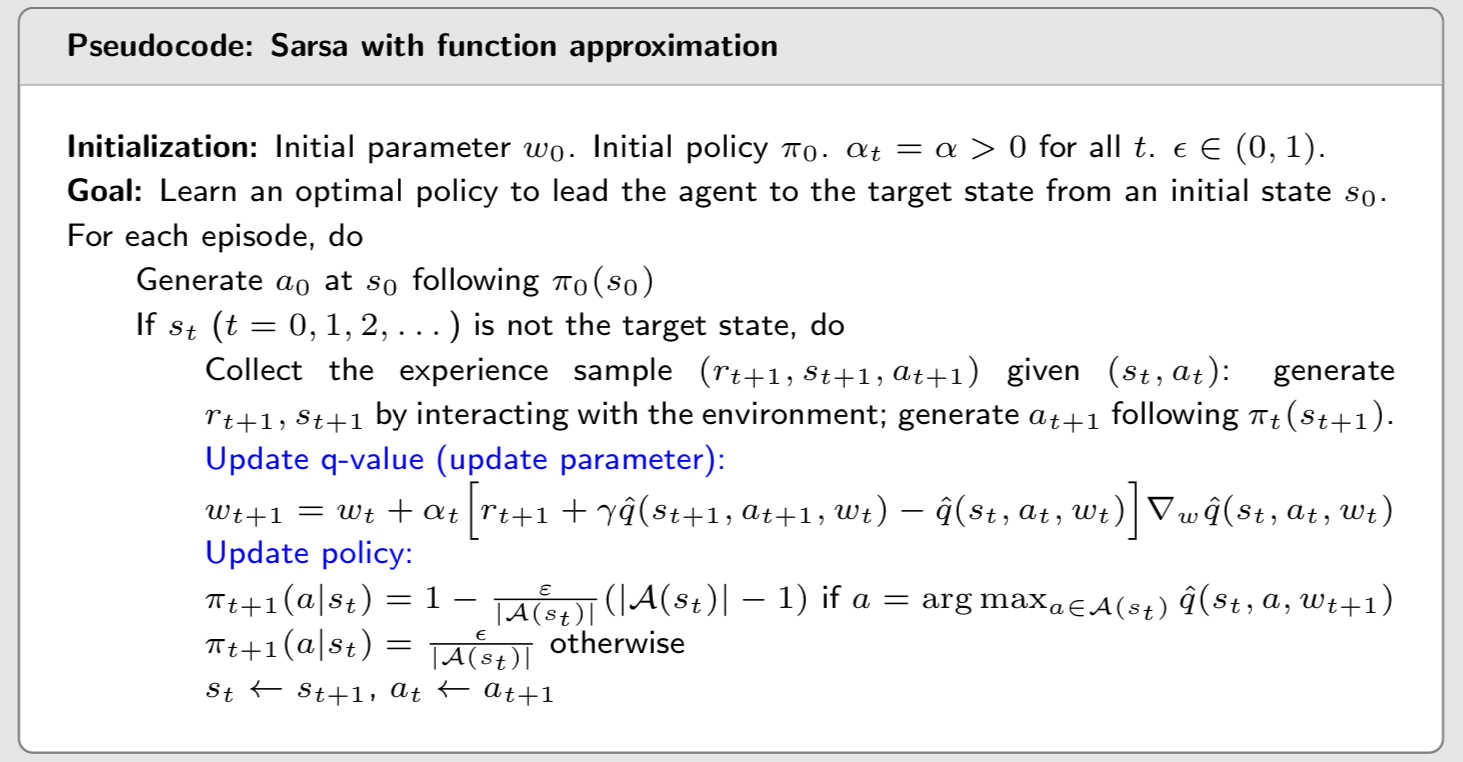
更新的對象從表格裡的一格變成參數 :
結構還是「TD error 乘以某個方向」,只是方向從單位向量變成 。事實上 tabular 的版本可以看成函數近似的特例:如果特徵向量 是 one-hot 的,那 就只有 那一個分量是 ,更新式就退化回上一篇的 Sarsa。
Q-learning with function approximation#
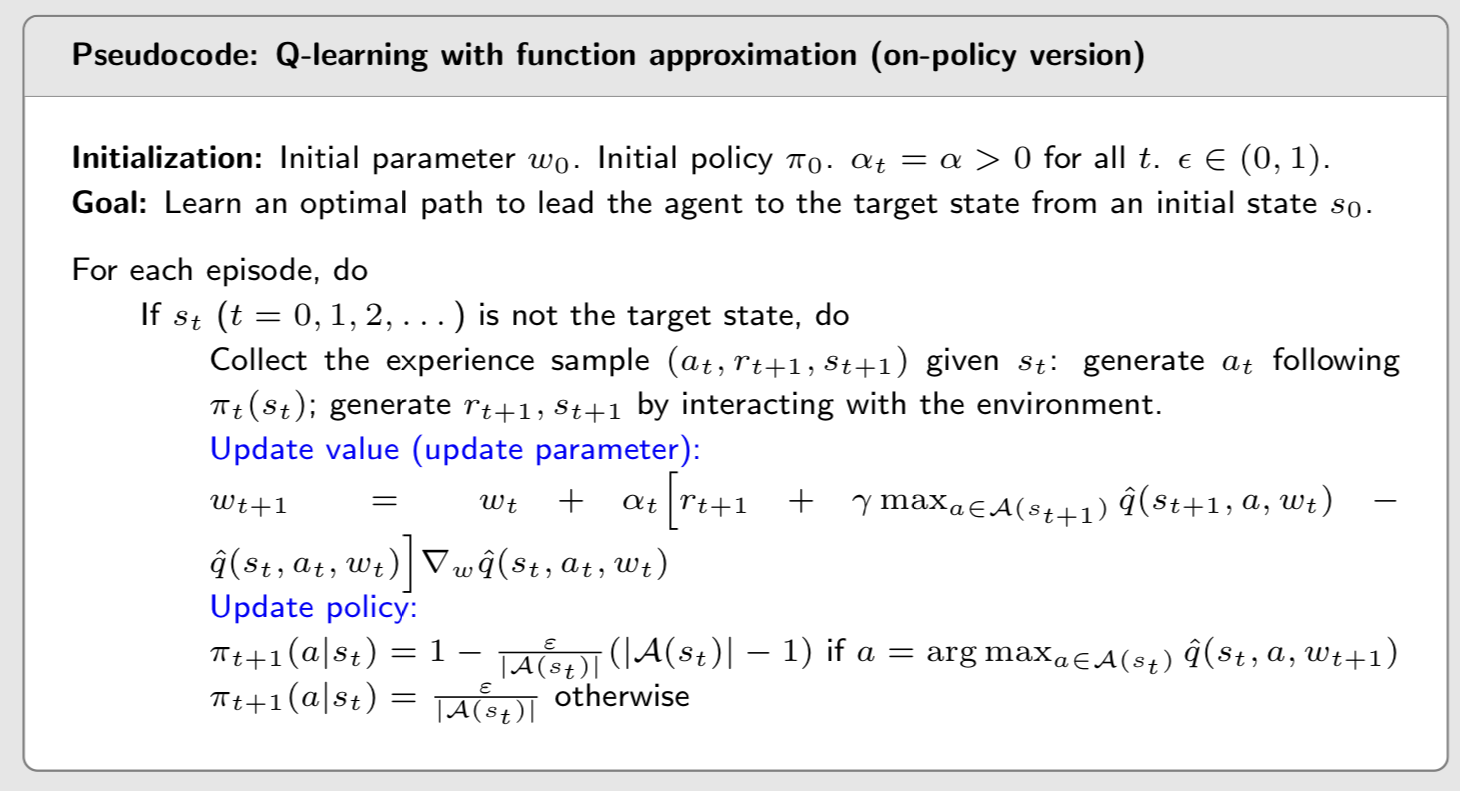
同樣地,Q-learning 只是把 TD target 換成 :
Deep Q-learning(DQN)#
再來就是引入 deep neural network 的時期了。The earliest and most successful algorithm that introduced deep neural networks into RL 就是 DQN:直接用一個深度神經網路當作 ,並且最小化底下這個目標函數:
也就是 Bellman optimality error 的平方期望值。不過直接用 SGD 去最小化它會遇到問題:目標值 裡也含有 ,每更新一次 ,目標值就跟著變,訓練會非常不穩定。DQN 用了兩個技巧來解決:
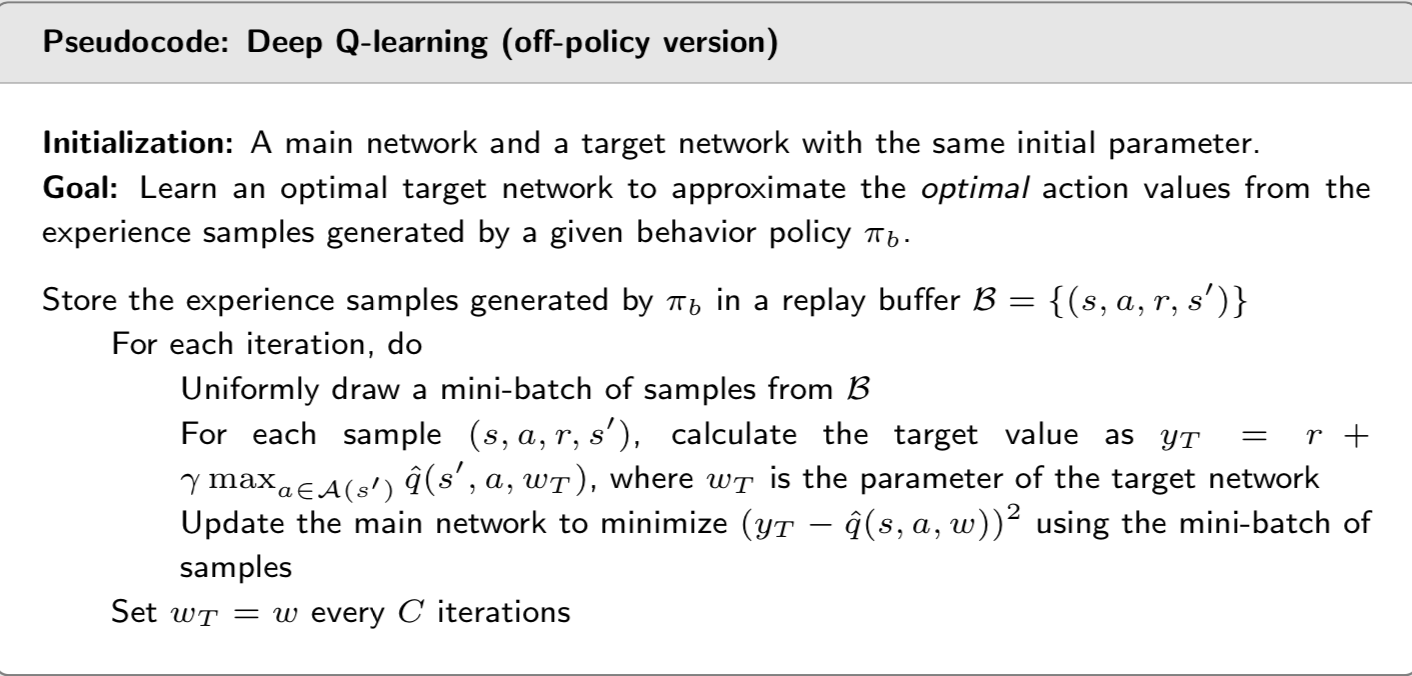
Target network:維護兩個網路。Main network 每一步都更新;target network 則固定不動,只在每 次迭代之後才把 複製過去。計算目標值時用的是 target network:
這樣一來目標值在一段時間內是固定的,最小化 就變成一個標準的 supervised regression 問題,只需要對 微分。
Experience replay:把 behavior policy 產生的樣本 全部存進一個 replay buffer ,訓練時從裡面均勻地抽 mini-batch,而不是按照樣本產生的順序來用。原因有兩個:
- 目標函數裡的期望值是對 取的,數學上假設它們是均勻分佈;但沿著一條 trajectory 收集的樣本前後高度相關、分佈也不均勻。從 buffer 均勻抽樣可以打破相關性,讓資料更接近這個假設。
- 每個樣本可以被重複使用很多次,資料效率高得多。
DQN 是 off-policy 的:資料由 behavior policy 產生並存進 buffer,學的是 optimal action value,這一點跟上一篇的 off-policy Q-learning 一樣,而 experience replay 之所以可行,也正是因為 Q-learning 本來就不在乎樣本是誰產生的。
從 value-based 到 policy-based:Policy gradient#
直接參數化 policy#
回頭看前面到現在的所有方法,在 policy improvement 這一步都是用 去做的:先估 value,再從 value 導出 policy,這叫 value-based。但其實我們是可以直接賦予 policy 參數的,寫成 。例如用一個神經網路,輸入 state、輸出每個 action 的機率(softmax), 就是網路的參數。這時候 policy 本身是一個機率分佈,改進 policy 就變成直接對 做最佳化,這叫 policy-based。
這樣做的好處是:可以自然地處理連續的 action space(輸出一個分佈的參數就好,不用對所有 action 取 max)、可以表示 stochastic policy,而且最佳化的對象直接就是我們真正關心的 policy。
Policy gradient theorem#
要最佳化就要先定義目標函數 ,用來衡量一個 policy 有多好。常見的選擇有兩種:
- Average state value:,也就是所有 state value 依照某個分佈 的加權平均
- Average reward:,也就是長期來看每一步平均能拿到的 reward
不管用哪一個,都可以證明它們的梯度有同樣的形式,這就是 policy gradient theorem:
其中 是 state 的分佈。這裡出現 的原因是一個小技巧:,把它代進去之後,原本對 action 的加總 就能寫成對 的期望值,而期望值就可以用採樣來估。這也要求 對所有 action 都成立,所以 policy 一定是 stochastic 的,也就自帶了 exploration。
有了梯度之後,就是我們現在常會看到的 policy gradient:用 gradient ascent 去最大化 ,並且跟 SGD 一樣把期望值換成一個樣本:
這條式子有一個很直覺的解讀。因為 ,所以它可以改寫成:
更新的方向是讓 變大的方向,而步伐的大小跟 成正比:好的 action 機率就往上調(exploitation),跟 成反比:目前很少被選到的 action 如果表現好,會被拉得更用力(exploration)。
REINFORCE#
上面的更新式裡還有一個 需要估計。最直接的做法是用 Monte Carlo:
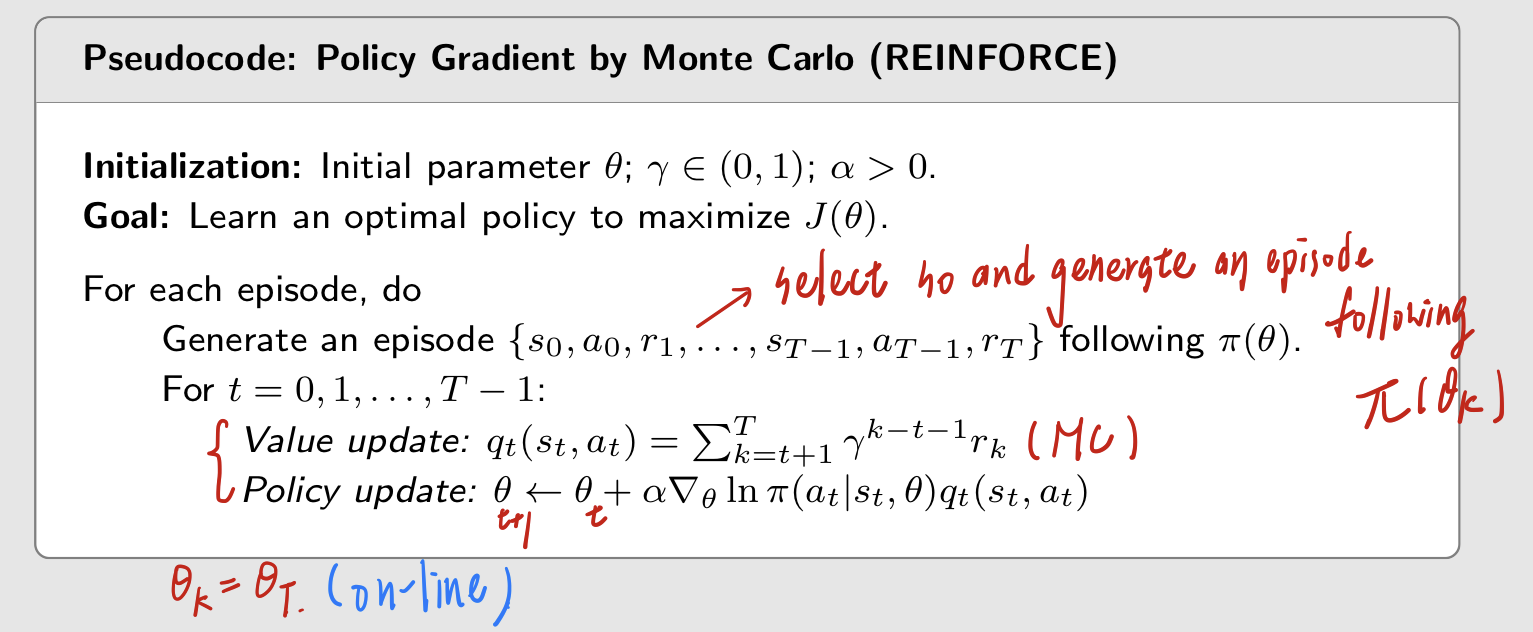
REINFORCE 每一輪先依照目前的 跑完一整個 episode ,然後對每個時間點 :
- Value update:用從 往後的 discounted return 當作 的估計,,這就是 MC
- Policy update:
REINFORCE 是 on-policy 的,因為 policy gradient theorem 裡的期望值是對目前的 取的,所以樣本必須來自目前的 policy;同時它也是 offline 的,因為要等 episode 結束才能算 return。
Actor-Critic#
那因為上面的 policy gradient 是用 REINFORCE 的方式做的,它是基於 MC 來估 的,就會有 MC 的所有問題:要等整個 episode 結束、變異數很大。而就如同上一篇,我們在 Sarsa 跟 Q-learning 已經找到了更好的做法,也就是用 TD 方法跟函數近似來估 value。所以把兩者結合起來,最終就會得到我們現在常見的 Actor-Critic 的設計了:
- Actor:負責 policy update,也就是上面的 policy gradient
- Critic:負責 value update,用 TD with function approximation 估計 ,提供給 actor 使用
最簡單的版本叫 QAC(Q actor-critic):
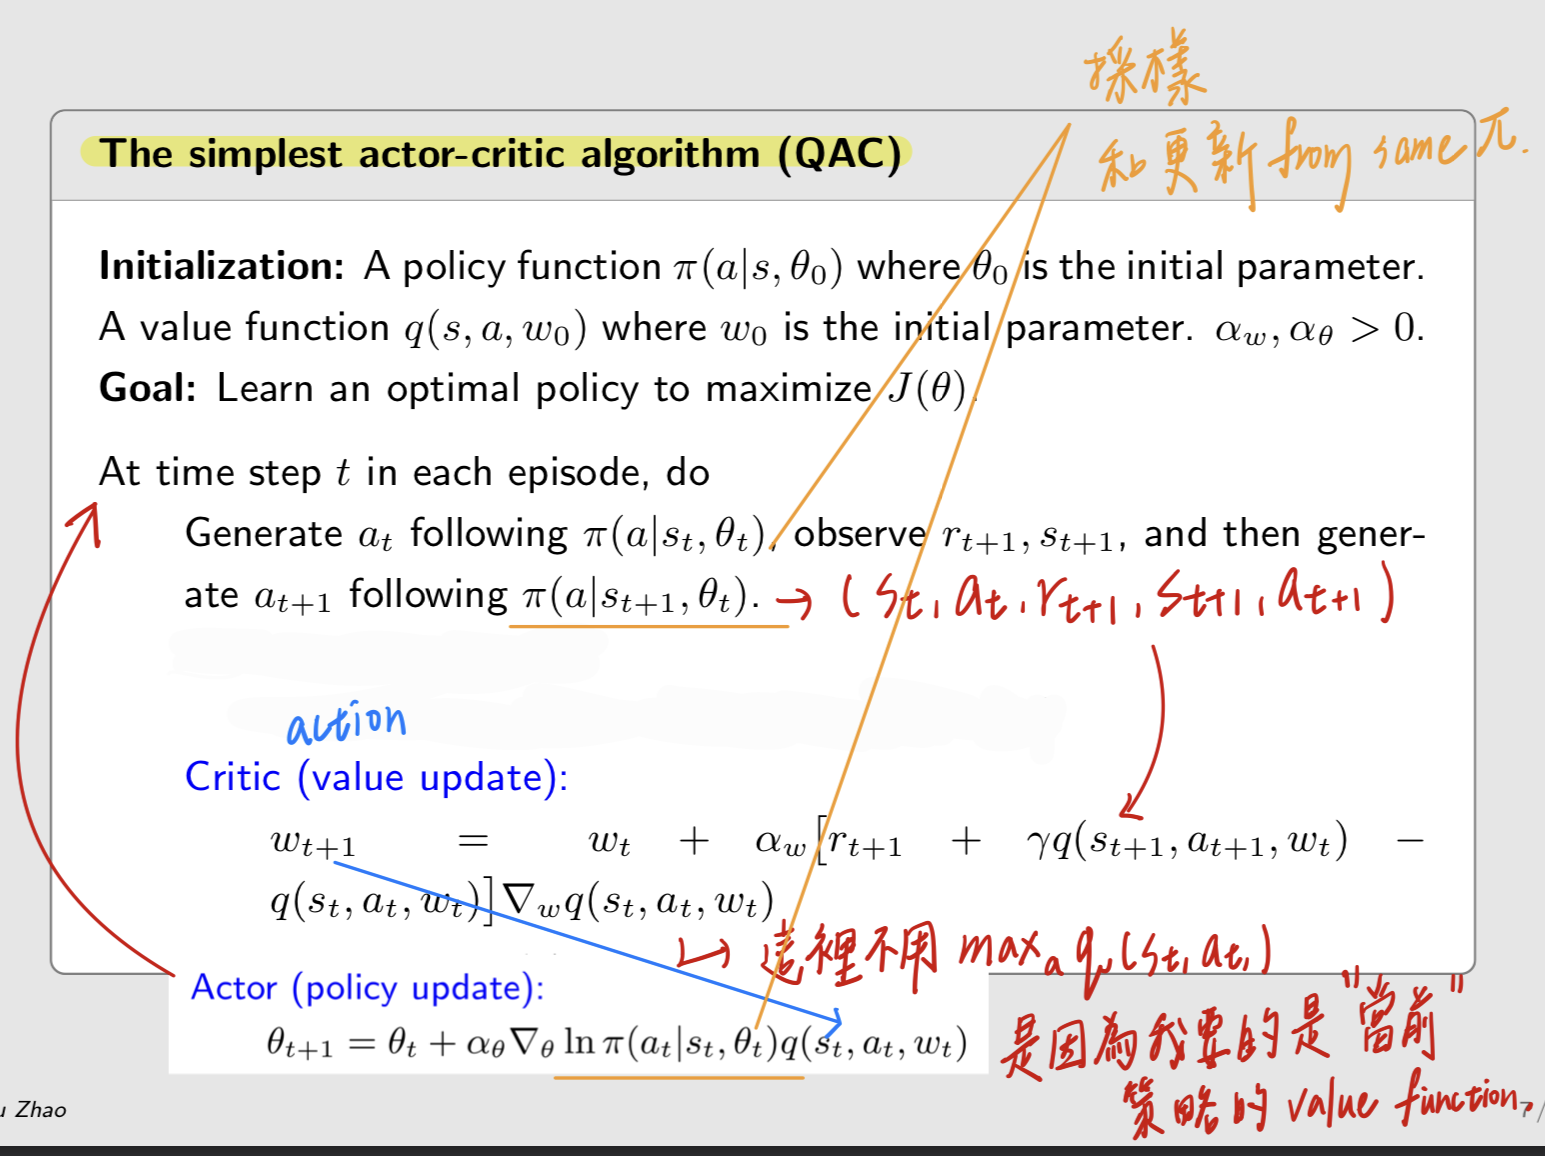
每一步先依照 產生 ,觀察 ,再依照同一個 policy 產生 ,得到一組 ,然後:
Critic(value update):
Actor(policy update):
可以看到 critic 的更新式就是前面的 Sarsa with function approximation,actor 的更新式就是 policy gradient,只是 換成了 critic 的輸出 。有兩點值得注意:
- 這裡 critic 用的是 Sarsa 而不是 Q-learning,也就是 TD target 不用 。原因是 policy gradient theorem 裡需要的是「當前策略」的 value function ,而不是最佳策略的 ;用 估出來的會是後者,跟 policy gradient 的推導不符。
- 採樣跟更新都來自同一個 ,所以 QAC 是 on-policy 的。
QAC 之後還有很多延伸。例如在 actor 的更新裡把 減去一個 baseline ,變成 advantage ,可以在不改變期望值的情況下大幅降低變異數,這就是 A2C(advantage actor-critic);如果想用其他 policy 產生的樣本來更新,可以透過 importance sampling 得到 off-policy 的 actor-critic,這也是 overview 圖上 Chapter 10 旁邊標的 on-policy 與 off-policy;針對連續的 action space 還有 deterministic policy gradient(DPG)。現在最常用的 PPO 等演算法,本質上也都是這個 actor-critic 框架的延伸。
結語#
回頭看整個系列的 overview 圖,整條路徑其實是一連串「解決上一步的問題」的過程:
- 先用 Bellman equation 定義一個 policy 的價值,用 Bellman optimality equation 定義最佳策略,並在模型已知的情況下用 value iteration 與 policy iteration 求解
- 沒有模型,就用 Monte Carlo 拿樣本平均取代期望值
- MC 要等整個 episode 結束,就用 Robbins-Monro 與 SGD 的想法改成 incremental 的 TD learning,得到 Sarsa 與 Q-learning
- 表格存不下、也無法 generalize,就把表格換成函數,再換成深度神經網路,得到 DQN
- 用 導出 policy 不適合連續動作,就直接參數化 policy,用 policy gradient 最佳化,得到 REINFORCE
- REINFORCE 用 MC 估 value 變異數太大,就把 TD 的 critic 加進來,得到 Actor-Critic
當然相關的細節還有很多,只是在這裡想呈現的是我對於強化學習理論基礎的理解,那就先大概講到這。