Reinforcement Learning(II)
- 發佈時間
前言#
這是強化學習系列的第二篇。上一篇從基本名詞講到 Bellman equation 與 Bellman optimality equation,並用 value iteration 與 policy iteration 兩個演算法說明了兩者的差異。但那些方法都是 with model 的:需要知道 state transition probability 跟 reward probability 。在實際情況中我們大多不會知道這兩個東西,所以這一篇要說明的是怎麼從 with model 走到 model-free。
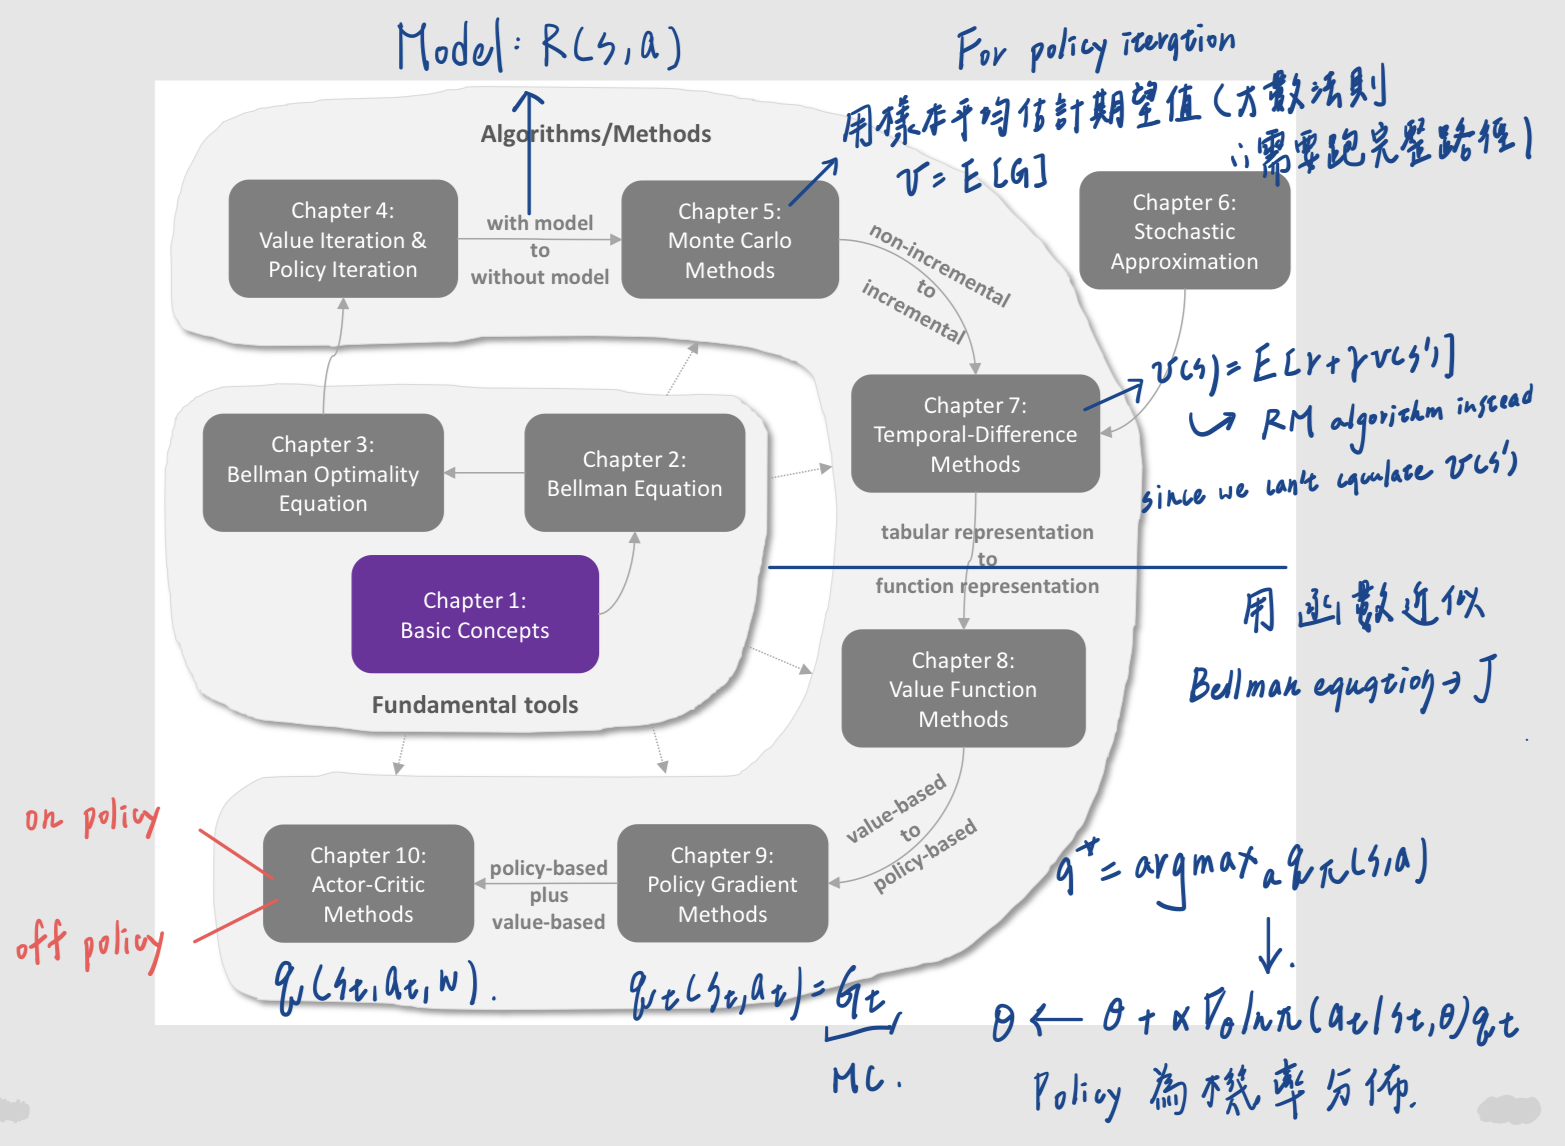
對應到上面的 overview 圖,這篇涵蓋的是 Chapter 5-7:
- Monte Carlo methods:用樣本平均取代期望值,第一次擺脫模型
- Stochastic approximation:Robbins-Monro 演算法與 SGD,讓估計可以一步一步遞增地做(incremental)
- Temporal-difference methods:把上面兩個想法結合起來,得到 Sarsa 與 Q-learning
從 with model 到 model-free:Monte Carlo methods#
至於要如何從 with model 到 model-free,我們需要加入新的想法,也就是 Monte Carlo methods:透過對樣本取平均來估計期望值。
背後的依據是大數法則(law of large numbers):對一個隨機變數 ,如果有 個獨立同分佈的樣本 ,那樣本平均 會隨著 變大而收斂到 。
回顧一下 action value 的定義:
- With model 的時候,我們是用 來算,這需要模型
- Model-free 的時候,直接回到定義:從 出發,依照 跑很多個 episode,把每一條的 return 平均起來
這裡估的是 action value 而不是 state value,原因是 model-free 時沒辦法從 推出 (那需要模型),而 policy improvement 需要的正是 。
MC Basic#
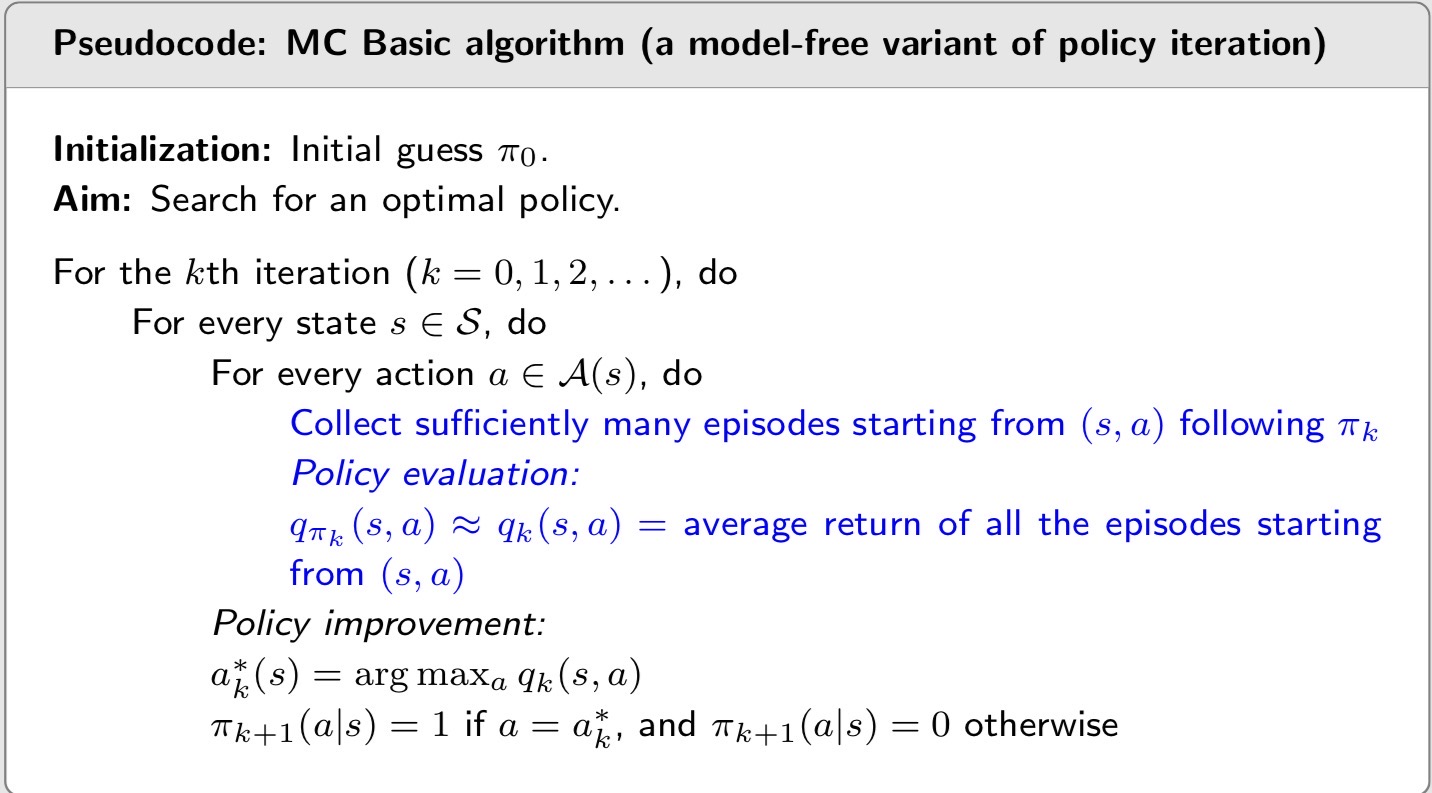
MC Basic 就是 policy iteration 的 model-free 版本:把 policy evaluation 從「解 Bellman equation」換成「採樣取平均」,policy improvement 則完全不變。
Monte Carlo methods 主要是針對 policy iteration,而不適用於 value iteration。原因是 policy iteration 每一輪都有一個明確的 policy 可以拿來產生樣本,所以 policy evaluation 可以用採樣代替;但 value iteration 中間的 並不對應任何一個 policy,它需要的是最優策略的樣本,而這是抽不到的。
MC Basic 要求對每一個 都收集足夠多完整的 episode,效率非常差,主要是拿來說明概念。書中還有兩個改進版本:
- MC Exploring Starts:一個 episode 裡會經過很多 state-action pair,把每一個都拿來更新對應的 ,而不是只用起點那一個
- MC -greedy:MC Basic 與 MC Exploring Starts 都要求每個 都要有機會當起點(exploring starts),實務上很難做到。改用 -greedy policy 之後,每個 action 都有機會被選到,就不需要這個條件了
-greedy policy 在後面的 Sarsa 與 Q-learning 也會一直用到,它的定義是:
也就是以大機率選目前最好的 action(exploitation),但保留一小部分的機率選其他 action(exploration)。 時就是 greedy policy; 越大探索越多,但學到的 policy 也離最佳越遠,所以常見的做法是隨著訓練逐步縮小 。
MC 的限制#
Monte Carlo 的問題在於它是 non-incremental 的:要等一整個 episode 跑完、算出 return 之後才能更新,也就是 overview 圖上寫的「需要跑完整路徑」。如果 episode 很長,甚至是 continuing task,這樣就不可行。
所以我們想要的是一種 incremental 的方法:每收到一步的資料就能更新一次。這就是接下來的 Temporal-Difference methods。但在講這個演算法之前,我們必須先來談談 Robbins-Monro 演算法,也就是從 stochastic approximation 聊起,因為 TD 的更新式正是它的一種特例。
Stochastic approximation:Robbins-Monro 演算法#
從 mean estimation 開始#
先看最簡單的例子:估計一個隨機變數 的期望值 。最直接的做法是收集 個樣本之後取平均,但這樣要等到所有樣本都到齊。換成遞增的寫法,記 為用前 個樣本算出的平均,那新樣本 進來時:
更一般地可以把 換成一個步長 :
這個形式是整篇文章的核心:新的估計 = 舊的估計 - 步長 (舊的估計 - 新的樣本)。每來一個樣本就能更新一次,不用等所有樣本到齊。後面會看到 TD、Sarsa、Q-learning 的更新式全部都長這樣。
Robbins-Monro 演算法#
Robbins-Monro(RM)演算法處理的是更一般的問題:求方程式 的根,但 是一個黑盒子,我們不知道它的表達式,只能觀察到帶有雜訊的量測值:
RM 演算法就是:
其中 是正的步長。直覺上,如果 是遞增的函數,那 表示 在根的右邊,要往左移;反之則往右移,而 控制每次移動的幅度。Robbins-Monro theorem 說,只要滿足底下三個條件, 就會以機率 1 收斂到根 :
- : 是單調遞增的(所以根唯一),而且梯度有上界
- 且
- 且 :雜訊的期望值為零、變異數有界
第二個條件值得多解釋一下。 保證 ,這樣更新的幅度會越來越小,最後才會穩定下來; 則保證步長不會縮得太快,否則 可能在還沒走到 之前就停住了。 就是一個同時滿足兩者的例子,這也正好是 mean estimation 裡的步長。
事實上 mean estimation 就是 RM 的特例:令 ,量測值 ,雜訊 的期望值為零,所以 正是 RM 演算法。
Stochastic gradient descent 是特殊的 RM 演算法#
接著看一個大家更熟悉的東西。考慮最佳化問題:
其中 是要最佳化的參數, 是隨機變數。用 gradient descent(GD)來解就是:
GD 的 drawback 是它需要算期望值,也就是需要知道 的分佈;如果不知道分佈,就得在每一次迭代、對每一個 都收集很多樣本來近似(batch gradient descent):
Stochastic gradient descent(SGD)做的事情就是把 true gradient 換成 stochastic gradient,也就是只用一個樣本:
為什麼這樣還能收斂?因為 SGD 其實就是 RM 演算法。我們要解的是 ,而我們能觀察到的量測值是:
雜訊的期望值為零,所以 SGD 就是 RM 演算法套用在 上,收斂性直接由 Robbins-Monro theorem 保證。順帶一提,mean estimation 也可以看成 SGD:令 ,梯度是 ,就得到 。
SGD 有一個很好的性質:當 離 很遠時,stochastic gradient 的相對誤差很小,SGD 的行為幾乎跟 GD 一樣;只有靠近 時隨機性才會變明顯。這也是它在實務上好用的原因。
之所以要繞這一圈,是因為接下來的 TD learning 更新式長得就是 RM 的形式,而它的收斂性也是用同一套理論證明的。
Temporal-Difference learning#
TD learning 的演算法#
先看最基本的 TD 演算法,它的目的是在給定 policy 的情況下估計 state value 。資料是依照 產生的一串樣本 ,每收到一步 就更新一次:
其他沒被拜訪到的 state 則維持不變, for 。式子裡有兩個重要的名字:
- TD target:,更新的方向就是把 往這個值推
- TD error:,也就是目前估計與 TD target 之間的差
為什麼 TD target 長這樣?因為 Bellman equation 可以改寫成期望值的形式:
這正是 overview 圖上寫的 。要在 model-free 的情況下解這條式子,就套用 RM 演算法:令 ,我們觀察到的量測值是 ,代進 RM 就得到 。
但這裡有個問題:量測值裡用到了 ,而這正是我們不知道、想要估的東西。TD 的做法是直接用目前的估計 來代替,這就是 overview 圖上寫的「RM algorithm instead since we can't calculate 」。用自己的估計來更新自己的估計,這種做法叫做 bootstrapping,而 TD 演算法的收斂性可以證明在跟 RM 類似的條件下仍然成立。
跟 MC 比較一下:
- MC 要等整個 episode 結束才能更新(offline),TD 每一步就能更新(online / incremental),所以 TD 也能處理 continuing task
- MC 的估計沒有偏差(unbiased)但變異數大,因為 return 累積了整條路徑的隨機性;TD 因為 bootstrapping 而有偏差,但變異數小,因為每次更新只牽涉到一步的隨機性
怎麼把 TD 用到 policy iteration 與 value iteration#
上面的 TD 演算法只能估 state value,而在 model-free 的情況下要改進 policy,需要的是 action value。所以接下來的兩個演算法都是直接估 ,並且分別對應到上一篇的兩條式子:
- 針對 policy iteration,是 Sarsa:用 TD 解 Bellman equation,估計目前 policy 的
- 針對 value iteration,是 Q-learning:用 TD 直接解 Bellman optimality equation,估計
Sarsa#
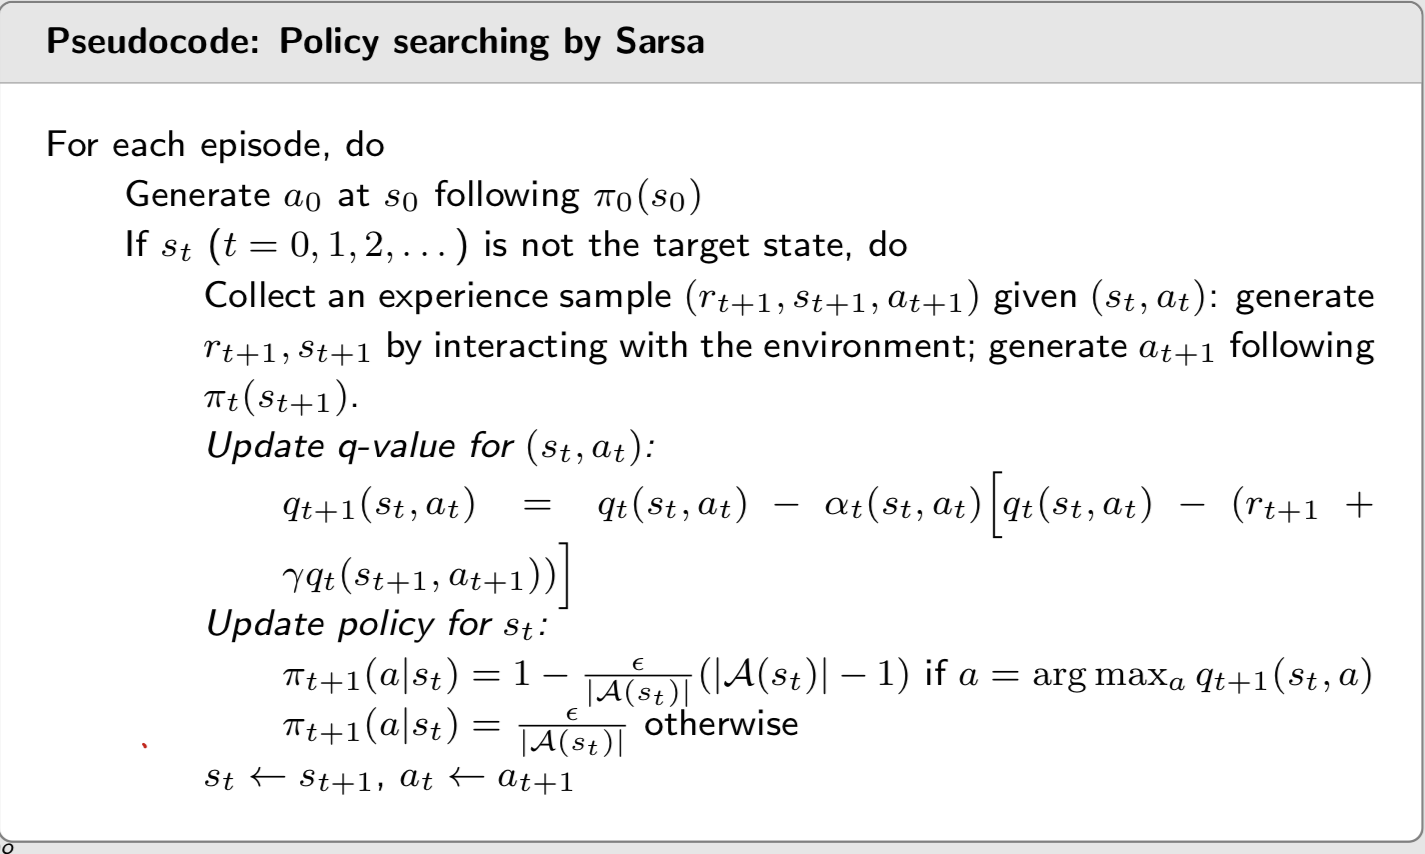
Sarsa 的更新式是:
名字來自每一步用到的資料 。它跟前面 TD 的差別只是把 state value 換成 action value,解的是 action value 版本的 Bellman equation:
Pseudocode 裡每一步做的事情就是 policy iteration 的縮影:先用一步 TD 更新 (policy evaluation),接著馬上用 -greedy 更新 的 policy(policy improvement)。跟 policy iteration 不同的是,這裡不會等 收斂才改進 policy,而是每走一步就交替做一次,可以看成是把 truncated policy iteration 推到極致。用 -greedy 而不是 greedy 的原因,是我們只能從自己執行的 policy 拿到樣本,如果 policy 完全 greedy,很多 永遠不會被拜訪到,也就永遠估不準。
Q-learning#
針對 value iteration 的則是 Q-learning,它的更新式是:
跟 Sarsa 唯一的差別在 TD target:Sarsa 用的是 ,也就是下一步實際採取的 action 的值;Q-learning 用的是 。這正好對應到 Bellman optimality equation 的 action value 形式:
所以 Q-learning 不是在評估某個特定的 policy,而是直接估計 optimal action value ,就像 value iteration 一樣。
Q-learning 還分為兩個版本,要理解差別得先講 on-policy 跟 off-policy。在 TD learning 裡其實有兩個 policy 在扮演不同角色:
- Behavior policy:實際跟環境互動、產生樣本的 policy
- Target policy:我們正在更新、最終想要學到的 policy
兩者相同就叫 on-policy,不同就叫 off-policy。Sarsa 是 on-policy 的:它的 TD target 用到 ,而 是由目前的 policy 產生的,所以它評估的就是產生資料的那個 policy。Q-learning 的 TD target 用的是 ,跟下一步實際選了什麼 action 無關,所以它不在乎樣本是誰產生的,可以是 off-policy 的。
On-policy 版本
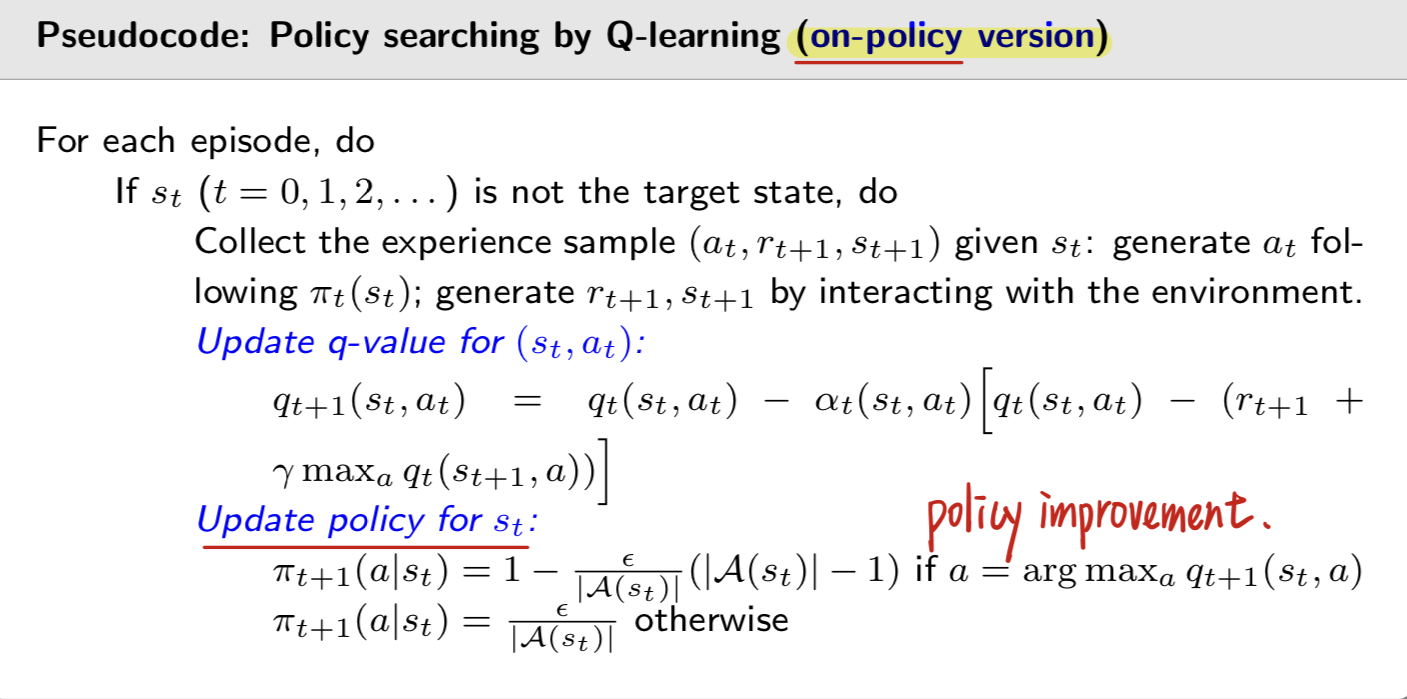
跟 Sarsa 幾乎一樣:用目前的 -greedy policy 產生資料,更新完 之後馬上更新同一個 policy。差別只在 TD target 用了 。
Off-policy 版本
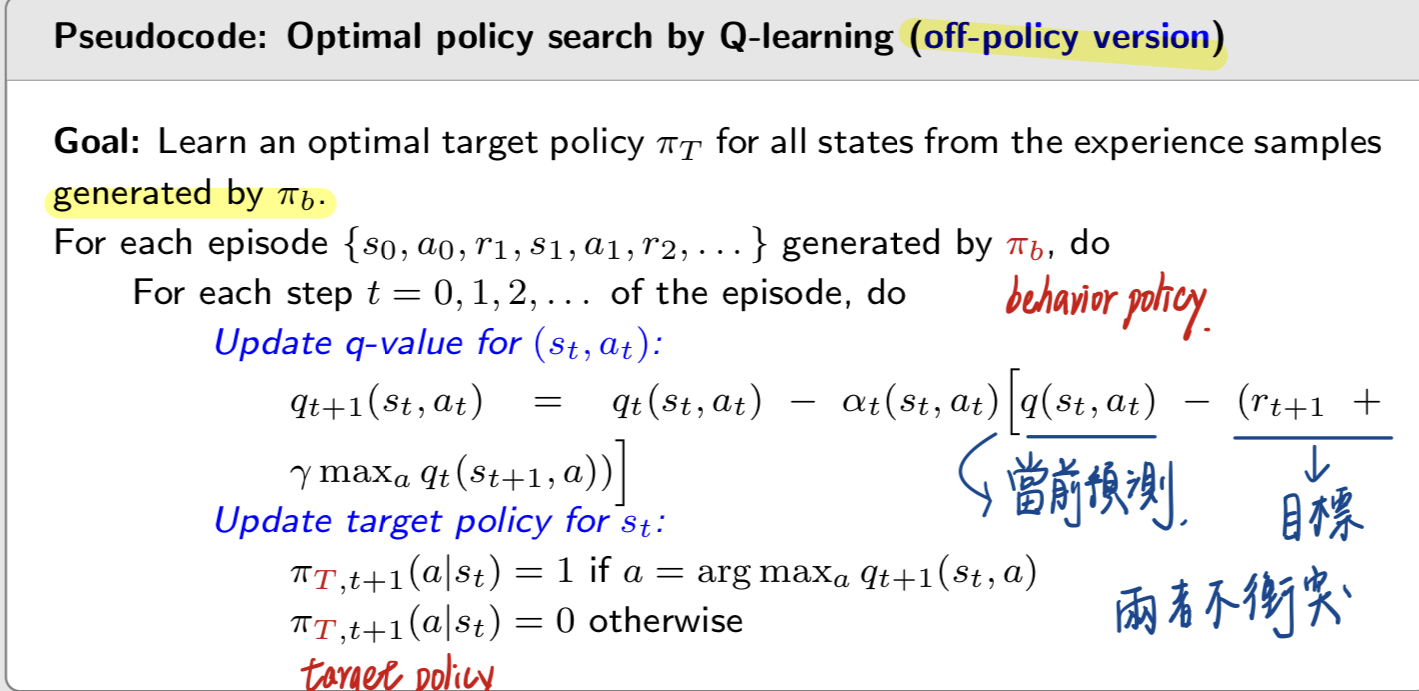
樣本全部由一個 behavior policy 產生(例如一個探索性很強的 policy,甚至是事先收集好的資料),而 target policy 直接取 greedy,不需要 。這是 off-policy 的好處:探索的責任交給 behavior policy,target policy 可以專心往最佳解走,兩者不會互相衝突。更新式裡方括號中的 是當前的預測, 是目標,更新就是把預測往目標推。
統一的觀點#
到這裡可以發現所有的 TD 演算法都可以寫成同一個形式:
差別只在 TD target 怎麼取:
| 演算法 | TD target | 解的方程式 |
|---|---|---|
| Sarsa | Bellman equation | |
| n-step Sarsa | Bellman equation | |
| Q-learning | Bellman optimality equation | |
| Monte Carlo | 的定義 |
其中 n-step Sarsa 是 Sarsa()跟 Monte Carlo()之間的折衷, 越大越接近 MC:偏差越小、變異數越大。
小結#
這一篇從 Monte Carlo 開始,用樣本平均取代模型;再透過 Robbins-Monro 與 SGD 理解為什麼「舊估計減去步長乘以誤差」這種遞增的更新可以收斂;最後把兩者結合成 TD learning,得到分別對應 policy iteration 與 value iteration 的 Sarsa 與 Q-learning。
到這邊為止,我們用的還是 tabular 的形式:把每個 存在一張表裡。這對 analyze 上來說非常方便,但同時缺點也很明顯,就是 difficult to handle large or continuous state or action spaces,不管從 storage 還是 generalization ability 來看都是。
下一篇 Reinforcement Learning(III) 要做的就是 from table to function:把 Sarsa 與 Q-learning 改寫成函數近似的版本、引入深度神經網路得到 DQN,再從 value-based 走到 policy-based 的 policy gradient 與 Actor-Critic。